Home › JurPC Web-Dok. 111/2017 Big Data im Lichte der EU-Datenschutz-Grundverordnung
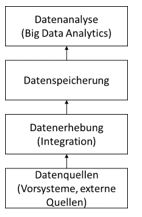
Der vorliegende Beitrag beschäftigt sich mit den Rahmenbedingungen für analytische Anwendungen wie Big Data, die durch das neue europäische Datenschutzrecht entstehen, insbesondere durch die EU-Datenschutz-Grundverordnung. Er stellt wesentliche Neuerungen vor und untersucht die spezifischen datenschutzrechtlichen Regelungen im Hinblick auf den Einsatz von Big Data sowie Voraussetzungen, die durch die Verordnung abverlangt werden. I. EinleitungAnalytische Anwendungen und Verfahren werfen – sofern sie mit personenbezogenen bzw. personenbeziehbaren Daten arbeiten – komplexe datenschutzrechtliche Fragen auf. Verfahren wie Data Mining oder insbesondere Big Data stellen hinsichtlich des Grundrechts auf Datenschutz, wie es in der Charta der Grundrechte der Europäischen Union verankert ist (Art. 8 Charta), ein besonderes hohes Gefährdungspotenzial für natürliche Personen dar[1]. Die wachsenden Möglichkeiten der Eingriffe in die Privatsphäre durch Big Data werfen zahlreiche rechtliche und ethische Fragen auf[2]. Am 25. Mai 2018 treten europaweit mit der Datenschutz-Grundverordnung (DS-GVO) (und wahrscheinlich auch der E-Privacy-Verordnung, die derzeit allerdings erst im Entwurf mit Stand Januar 2017 vorliegt) wichtige neue Datenschutzbestimmungen in Kraft. Diese Verordnungen sind ein Ansatz, u.a. auch Antworten auf rechtliche Fragen bzgl. Big Data zu geben. Eines der vordringlichsten Ziele bei der Erarbeitung der DS-GVO war eine Anpassung europäischen Datenschutzrechts an die zunehmende Digitalisierung[3]. In diesem Zusammenhang spielen datenbasierte Geschäftsmodelle und – eng mit diesen Geschäftsmodellen verbunden – die Auswertung großer Datenmengen mit Big Data[4] eine zentrale Rolle. Für Unternehmen – auf diesen Anwendungsbereich bezieht sich der Beitrag – gilt es nun, bis zum 25. Mai 2018 Konformität mit dem neuen Datenschutzrecht herzustellen. Dies bedeutet teilweise erheblichen Vorbereitungs- und Anpassungsaufwand, insbesondere auch beim Einsatz analytischer Verfahren wie Data Mining und Big Data sowie der Vorhaltung entsprechender Datensammlungen. Regelungen, die sich auf analytische Anwendungen und Verfahren auswirken, finden wir in der DS-GVO. II. Die Datenschutz-GrundverordnungDie DS-GVO löst die EU-Datenschutz-Richtlinie aus dem Jahre 1995 ab. Sie verfolgt das Ziel Grundrechte und Grundfreiheiten natürlicher Personen, insbes. deren Recht auf den Schutz personenbezogener Daten (Art. 1 DS-GVO) und nimmt dabei Bezug auf Artikel 8 der Charta der Grundrechte der Europäischen Union (ErwG 1 DS-GVO). Sie ist also operationalisierter Grundrechtsschutz des in Artikel 8 der Charta garantierten Datenschutzgrundrechts[5]. Als Verordnung ist sie ein Instrument der Vollharmonisierung europäischen Rechts, d.h. sie gilt unmittelbar in allen Mitgliedsstaaten und löst bisheriges nationales Recht ab (in Deutschland das Bundesdatenschutzgesetz). Sie hat Anwendungsvorrang[6] vor nationalem Recht. Das Datenschutzrecht – so auch die DS-GVO – setzt einen Personenbezug der zu verarbeitenden Daten voraus. Dort, wo Big Data-Anwendungen Daten ohne jeden Personenbezug (anonyme Daten) analysieren, findet das Datenschutzrecht keine Anwendung. „Big Data heißt nicht notwendig Big Personal Data."[7]. Die Zusammenführung verschiedenster Daten zu großen Datenmengen erleichtert jedoch potenziell die Aufhebung von Anonymität.[8] Die Verordnung behält weitgehend die bereits aus der Datenschutz-Richtlinie bekannten Grundsätze bei[9], bringt aber auch Neuerungen im Grundsätzlichen sowie im Detail (siehe dazu Übersichtsbeiträge in der Literatur[10]). Die Rechtmäßigkeit der Verarbeitung (Art. 6 DS-GVO) folgt weiterhin dem Prinzip des Verbots mit Erlaubnisvorbehalt[11]. Dabei werden Unternehmen insbes. die Legitimationsmöglichkeiten der informierten Einwilligung, der Vertragserfüllung sowie die Wahrnehmung berechtigter Interessen (sofern die schutzwürdigen Interessen nicht überwiegen) in Betracht ziehen können. Die Grundsätze des Datenschutzes (Art. 5 DS-GVO) sind ebenfalls bereits aus dem bislang geltendem Recht bekannt: › Rechtmäßigkeit, Verarbeitung nach Treu und Glauben, Transparenz, › Datenminimierung, › Zweckbindung, › Richtigkeit, › Speicherbegrenzung (Erforderlichkeit), › Integrität und Vertraulichkeit, › Rechenschaftspflicht. Diese Grundsätze sind für die Auslegung aller weiteren Regelungen der DS-GVO anzuwenden und gelten für alle Verarbeitungen personenbezogener Daten. Auf ausgewählte Neuerungen wird im Folgenden kurz eingegangen. Die DS-GVO gilt für Unternehmen, die eine Niederlassung innerhalb der EU haben sowie – dies ist eine grundsätzliche Neuerung – für Unternehmen, die Waren oder Dienstleistungen in der EU anbieten (auch unentgeltlich) oder das Verhalten von Personen in der EU beobachten. Diese Beobachtung meint die Erhebung von Internetaktivitäten (Tracking) sowie eine nachfolgende Profilbildung. Dieses Marktortprinzip ist ein Paradigmenwechsel, es gilt unabhängig davon, wo diese Unternehmen ihren Sitz haben oder wo die Datenverarbeitung stattfindet (Art. 3 Abs. 2 DS-GVO). Im europäischen Datenschutzrecht sind mit dem Datenschutz durch Technikgestaltung (Privacy by Design) und durch datenschutzfreundliche Voreinstellungen (Privacy by Default) zwei neue Konzepte eingegangen (Art. 25 DS-GVO).[12] Datenschutz durch Technik soll bereits proaktiv während der Entwicklung angemessene technische und organisatorische Maßnahmen einführen, die ein angemessenes Datenschutzniveau gewährleisten (etwa Pseudonymisierung) und Grundsätze wie Datenminimierung konkret umsetzen. Eine Voreinstellung gilt dann als datenschutzfreundlich, wenn nur die personenbezogenen Daten verarbeitet werden, die für den jeweiligen Zweck objektiv erforderlich sind. Damit wird bereits bei der Erhebung von Daten eine technikseitige Beschränkung gefordert, die bspw. eine zweckfreie Sammlung „auf Vorrat" für Big Data unterbinden soll. Das bekannte Verbotsprinzip wird in der DS-GVO an manchen Stellen durch das Risikoprinzip ergänzt. Dabei wird die Zulässigkeit einer Datenverarbeitung ebenso wie die zu treffenden Maßnahmen in Abhängigkeit von Risiken für die persönlichen Rechte und Freiheiten betroffener Personen getroffen (Art. 24 DS-GVO). Abwägungskriterien für die Risikoanalyse enthält der ErwG 75 der DS-GVO. Ein zentrales Instrument der Risikoanalyse und -bewertung ist die Datenschutz-Folgenabschätzung (Art. 35 DS-GVO), die für den Einsatz typischer Big Data-Verfahren zwingend durchzuführen sein wird (s.u.). Die DS-GVO nimmt eine Beweislastumkehr vor. Unternehmen haben jederzeit den Nachweis zu erbringen, dass sie die Verarbeitung gemäß der Verordnung durchführen (Art 24 Abs. 1 DS-GVO). Insbes. gilt die Rechenschaftspflicht bzgl. der angeführten Grundsätze des Datenschutzes. Ihre Einhaltung muss nachweisbar sein (Art. 5 Abs. 2 DS-GVO). Kern der Dokumentations- und Nachweispflichten ist das Verzeichnis von Verarbeitungstätigkeiten (Art. 30 DS-GVO). Die erweiterte Rechenschaftspflicht verbunden mit den in den nächsten Absätzen angesprochenen Bußgeld- und Haftungserweiterungen stellt den Datenschutz in den Mittelpunkt von Compliance-Management-Systemen[13]. Mit dem in Krafttreten der DS-GVO werden drastisch höhere Bußgelder eingeführt. Diese sollen in jedem Falle „wirksam, verhältnismäßig und abschreckend" sein (Art. 83 DS-GVO). Je nach Einordnung der Verstöße gegen die DS-GVO werden Bußgelder für Unternehmen und natürlichen Personen in Höhe von bis zu 10 Mio. Euro (bzw. 2% des globalen Umsatzes) oder bis zu 20 Mio. Euro (bzw. 4% des globalen Umsatzes) möglich. Es gilt jeweils der höhere Betrag. Die deutlich erhöhten Bußgelder werden dazu beitragen, den bislang zu konstatierenden Mangel an Durchsetzungsfähigkeit im Datenschutzrecht zu vermindern[14]. Ebenfalls erheblich erweitert wird die zivilrechtliche Haftung, da nun neben materiellen Schäden explizit auch immaterielle Schäden zu erstatten sind (Art. 82 Abs. 1 DS-GVO), sofern diese durch Verstöße gegen die DS-GVO entstanden sind. III. Big Data und die Grundsätze des DatenschutzesWie nach bisherigem Recht, so unterliegt auch nach DS-GVO jede Verarbeitung personenbezogener Daten der Anforderung der Rechtmäßigkeit und der Einhaltung der Grundsätze des Datenschutzes (s.o). Dies galt bisher bereits für den Einsatz analytischer Verfahren[15] sowie den ihnen zugrunde liegenden Datensammlungen, z.B. in einem Data Warehouse[16]. Für Big Data – wesentliche Verfahren sind hier das Profiling, das Scoring und das Screening – sowie für diese Zwecke angelegten Datenpools gilt entsprechendes. Der Begriff der Verarbeitung ist weit gefasst (Art. 4 Abs. 2 DS-GVO). Er beginnt bereits mit der Erhebung personenbezogener Daten, bezieht sämtliche mögliche Verarbeitungsweisen bzw. -schritte ein und endet bei der Löschung der Daten. Wesentliche Grundsätze für unsere Betrachtung sind die Datenminimierung, die Zweckbindung und die Speicherbegrenzung (Erforderlichkeit). Rechtmäßigkeitsanforderungen und Grundsätze des Datenschutzes können auf die wesentlichen Verarbeitungsschritte einer analytischen Anwendung (Abb. 1) bezogen werden. Abb. 1: Verarbeitungsschritte in einer analytischen Anwendung
Im Unternehmen sind Datenquellen oft operative Systeme (ERP, CRM usf.). In diesem Fall wird eine Legitimation vorliegen, meist werden diese Daten zur Erfüllung eines Vertrags oder aufgrund einer Einwilligung gespeichert, jeweils mit Zweckbindung. Werden Daten direkt für Analysezwecke erhoben (bspw. durch das Tracking von Internetaktivitäten oder aus App-Nutzungen) muss dafür ebenfalls eine entsprechende Legitimation vorliegen, die diesem Zweck entspricht. Die Zusammenführung von Daten aus verschiedenen Quellen ist aus datenschutzrechtlicher Sicht eine (neue) Datenerhebung, da die Kombination i.d.R. zu einem neuen Informations- und Aussagegehalt über eine betroffene Person führt. Dies stellt eine erlaubnisbedürftige Kategorie der Verarbeitung personenbezogener Daten dar. Zudem tritt eine Abweichung von der Zweckbindung der Daten ein. Die Einwilligung des Betroffenen in den ursprünglichen Verwendungszweck ist dafür i.d.R. keine hinreichende Legitimation, das Bestimmtheitserfordernis von Einwilligungen deckt eine solche erweiterte Anwendung kaum ab[17]. Häufig sind Analysezwecke auf längere Sicht nicht bekannt oder festgelegt. Datensammlungen werden angelegt, um zum Zeitpunkt der Speicherung noch nicht bekannten Analysezwecken zu dienen. Dies widerspricht grundsätzlich den Anforderungen der Erforderlichkeit, der Zweckbindung, der Datenminimierung und der Speicherbegrenzung. Eine zweckfreie Erhebung bzw. Haltung von personenbezogenen Daten auf Vorrat ist grundsätzlich nicht zulässig[18]. Auch für Analysezwecke angelegte Datensammlungen gelten grundsätzlich die Rechte der Betroffenen auf Berichtigung (Art. 16 DS-GVO), Löschung (Art. 17 DS-GVO) oder das Widerspruchsrecht gegen eine Verarbeitung (Art. 21 DS-GVO). Eine Datenanalyse generiert – so das Ziel – neue Erkenntnisse über betroffene Personen. Diese Erkenntnisse werden repräsentiert durch neu gewonnene Daten und i.d.R. in verschiedenen Datenpools des Unternehmens gespeichert werden. Bspw. wird aufgrund einer Datenanalyse ein Kunde eines Unternehmens einem bestimmten Segment einer Kundensegmentierung zugewiesen, da er die typischen Merkmale (wie z.B. Einkommen, Preissensibilität, Bedürfnisse, Affinität zu bestimmten Produkten oder weiteren Verhaltensaspekten) dieses Segments teilt. Das Segment wird im Kundendatensatz etwa im CRM-System abgespeichert. Dies stellt eine neue Datenerhebung dar, die einer entsprechenden Legitimation bedarf. Die Zweckbindung ist der zentrale Ansatzpunkt[19]. Personenbezogene Daten dürfen nur für den Zweck genutzt werden, für den sie erhoben wurden. Der Zweck muss festgelegt werden, er hat eindeutig zu und legitim zu sein (Art. 5 Abs. 1, Nr. b DS-GVO). Aufgrund der Notwendigkeit der Angabe eines konkreten Zwecks bei der Datenerhebung sind zweckfreie analytische Anwendungen (wie bei Big Data-Anwendungen i.d.R. der Fall) mit dem Prinzip der Zweckbindung so gut wie nicht vereinbar[20]. Anders als das alte BDSG sieht die DS-GVO jedoch die begrenzte Möglichkeit einer Zweckänderung vor (Art. 6 Abs. 4 DS-GVO). Eine Zweckänderung ist danach nur zulässig, wenn der neue Zweck mit dem alten Zweck vereinbar ist. Für die Prüfung werden verschiedene Kriterien genannt: (a) die Verbindung zwischen den Zwecken, (b) der Zusammenhang, in dem die Daten erhoben wurden, (c) die Art der Daten (insbes. ob besondere Kategorien von Daten verarbeitet werden), (d) die möglichen Folgen für den Betroffenen und (e) getroffene Maßnahmen zum Schutz der Betroffenen (insbes. Verschlüsselung oder Pseudonymisierung). Zwar wird mit dieser Möglichkeit der Zweckänderung der Einsatz von Big Data potenziell erleichtert – allerdings in engen Grenzen und mit hohem Aufwand für die Prüfung und einer umfassenden Interessenabwägung zwischen dem neuen und dem ursprünglichen Verarbeitungszweck sowie der damit verbundenen Nachweispflicht. Inwiefern eine Abgleichung des ursprünglich festgelegten Zwecks mit einer meist zweckfreien Big Data-Anwendung überhaupt möglich ist, bleibt derzeit eine offene Frage. IV. Spezifische Regelungen für Big DataDie DS-GVO kennt in der Fachwelt gängigen Begriffe wie „Big Data", „Business Intelligence", „Analytik", „Data Mining" oder „Text Mining" nicht. In den Begriffsbestimmungen der Verordnung werden Verfahren zur Analyse und Prognose unter dem Begriff Profiling definiert: „Profiling [ist] jede Art der automatisierten Verarbeitung personenbezogener Daten, die darin besteht, dass diese personenbezogenen Daten verwendet werden, um bestimmte persönliche Aspekte, die sich auf eine natürliche Person beziehen, zu bewerten, insbesondere um Aspekte bezüglich Arbeitsleistung, wirtschaftliche Lage, Gesundheit, persönliche Vorlieben, Interessen, Zuverlässigkeit, Verhalten, Aufenthaltsort oder Ortswechsel dieser natürlichen Person zu analysieren oder vorherzusagen" (Art. 4 Nr. 4 DS-GVO). Big Data wird in der DS-GVO also unter Profiling definiert. Hier tritt ein Ziel der Verordnung hervor, ihr technikneutrale Ansatz: Auf eine Spezifizierung bestimmter technischer Verfahren wurde verzichtet zugunsten grundlegender Wirkungsweisen.[21] Es geht um die Bewertung persönlicher Aspekte, um deren Analyse und ihre Vorhersage, nicht um die technologische Methode. Spezifische Analyseverfahren – wie bspw. Scoring oder Predicting – fallen ebenfalls unter diese Begriffsbestimmung[22]. Die Einschränkung auf „automatisierte Verfahren" dürfte in der Praxis keine Rolle spielen, nicht-automatisierte Verfahren in diesem Sinne sind kaum vorstellbar. Auf diese umfassende Definition greift nun Artikel 22 der DS-GVO zurück und ordnet das Profiling als einen speziellen Fall der automatisierten Einzelentscheidung ein: „Die betroffene Person hat das Recht, nicht einer ausschließlich auf einer automatisierten Verarbeitung – einschließlich Profiling – beruhenden Entscheidung unterworfen zu werden, die ihr gegenüber rechtliche Wirkung entfaltet oder sie in ähnlicher Weise erheblich beeinträchtigt." (Art. 22 Abs. 1 DS-GVO) Das ausschließlich automatische Profiling wäre danach unzulässig, wenn für Betroffene eine rechtliche Wirkung entstünde oder sie in „ähnlicher Weise erheblich beeinträchtigt" würden. Wenn – um auf das obige Beispiel zurückzukommen – ein Kunde automatisch als Ergebnis einer Datenanalyse einem Segment einer Kundensegmentierung zugeordnet wird, ist dies eine automatische Einzelentscheidung. Wird diese Zuordnung etwa mit Maßnahmen einer Kundenstrategie verbunden, wie bspw. dem Ausschluss von Leistungen oder höheren Tarifen für bestimmte Leitungen, entfaltet sie rechtliche Wirkung. Eine menschliche Intervention ist in diesen Fällen zwingend und soll den Einzelnen vor einem Bewertungsautomatismus[23] schützen. Was allerdings in ähnlicher Weise als erhebliche Beeinträchtigung anzusehen ist, bleibt zunächst offen, die DS-GVO gibt in Erwägungsgrund 71 allenfalls vage Hinweise. Ausnahmen von diesem Verbot (Art. 22 Abs. 2) sind möglich, falls die Entscheidung bzw. das Profiling für den Abschluss oder die Erfüllung eines Vertrags objektiv erforderlich (z.B. die Messung des Stromverbrauchs durch Smart Meter) ist oder eine ausdrückliche Einwilligung der betroffenen Personen vorliegt. Unternehmen müssen jedoch auch in diesen Ausnahmefällen ein Verfahren einrichten, dass Betroffenen die Möglichkeit auf Einspruch gegen die Entscheidung einräumt. Besonders sensible personenbezogene Daten (wie in Art. 9 DS-GVO definiert) dürfen nicht Grundlage für ein Profiling sein (Art. 22 Abs. 4). Kinder sollen von einem Profiling generell nicht betroffen werden (ErwG 71 DS-GVO). Der bundesdeutsche Gesetzgeber hat im neuen Bundesdatenschutzgesetz (BDSG neu), dem Umsetzungsgesetz der DS-GVO, eine Öffnungsklausel genutzt und zum Schutz des Wirtschaftsverkehrs bei Scoring und Bonitätsauskünften (Auskunfteien) Ausnahmen unter bestimmten Voraussetzungen vorgesehen (§ 31 BDSG neu). Wird ein Profiling nach Artikel 22 angestrebt, so gelten zusätzliche Informationspflichten (Art. 13 und 14 DS-GVO), die mindestens aussagekräftige Informationen über die involvierte Logik sowie die Tragweite und die angestrebten Auswirkungen für die betroffene Person beinhalten. Für ein Profiling werden geeignete mathematische oder statistische Verfahren verlangt (ErwG 71 DS-GVO), die diskriminierende Wirkungen[24] (hinsichtlich Rasse, ethnischer Herkunft, politischer Meinung, Religion oder Weltanschauung, Gewerkschaftszugehörigkeit, genetischer Anlagen oder Gesundheitszustand oder sexueller Orientierung) ausschließen und verhindern, dass es zu Maßnahmen kommt, die eine diskriminierende Wirkung haben (Neutralität der Algorithmen). Auch werden technische und organisatorische Maßnahmen gefordert die geeignet sind, dass keine unrichtigen personenbezogenen Daten verarbeitet werden und diese Daten in einer Weise sichern, dass potenziellen Bedrohungen für die Interessen und Rechte Betroffener Rechnung getragen wird. Die häufig als Lösung vorgeschlagene Anonymisierung der Daten hilft in vielen Fällen nicht weiter. Abgesehen davon, dass dieser Ansatz (kunden)individuelle Analysen unmöglich macht, bleibt die Gefahr einer Re-Identifizierung[25]. Anonymität ist gefährdet, wenn der technische und finanzielle Aufwand eine Re-Identifizierung nicht mehr unangemessen erscheinen lässt. Die Zusammenführung diverser Datenbestände für Big Data und der Einsatz mächtiger Analyse-Algorithmen machen jede Anonymisierung auf Dauer unmöglich, die Unterscheidung von Daten mit oder ohne Personenbezug weitgehend hinfällig[26]. Für Unternehmen muss sich damit ständig die Frage stellen, ob eine vorgenommene Anonymisierung nach dem Stand der Technik noch greift und ob ggf. neue Risiken einer Re-Identifizierung entstanden sind[27]. Die DS-GVO bezieht ausdrücklich auch identifizierbare natürliche Personen in ihren Schutzbereich ein. V. Risikobewertung als Voraussetzung von Big DataBesondere Risiken der Verarbeitung personenbezogener Daten entstehen für Betroffene dann, wenn durch Profiling Verhaltensaspekte analysiert, bewertet und prognostiziert sowie ggf. automatisierte Einzelentscheidungen getroffen werden. Gerade in diesem Umfeld greift der risikobasierte Ansatz der GS-GVO. Das zentrale Instrument der Risikoanalyse, -bewertung und -abschätzung ist die Datenschutz-Folgenabschätzung (DSFA) (Art. 35 DS-GVO). Sie löst die bisherige Vorabkontrolle ab und ist durchzuführen, wenn durch eine Verarbeitung ein hohes Risiko für die persönlichen Rechte und Freiheiten der betroffenen Personen entsteht[28]. Dies ist immer der Fall, wenn (ErwG 91 DS-GVO) eine große Zahl von Personen betroffen ist, in großem Umfang neue Technologie eingesetzt wird oder wenn für das Treffen von Entscheidungen in Bezug auf bestimmte natürliche Personen im Anschluss an eine systematische und eingehende Bewertung persönlicher Aspekte natürlicher Personen auf der Grundlage eines Profilings erfolgt (Art 35 Abs. 3 DS-GVO). Der Leitfaden zur DSFA der Artikel-29-Datenschutzgruppe führt eine Reihe von Fällen auf, die ein grundsätzlich ein hohes Risiko darstellen und somit eine DSFA voraussetzen. Dort werden u.a. konkret angeführt[29]: Scoring, Profiling und Predicting, Automatische Entscheidungen, die zu rechtlichen Folgen für Betroffene führen, Datenverarbeitung in großem Umfang (Kriterien: Anzahl der Betroffenen, Menge der Daten etc.) sowie die Zusammenführung bzw. Kombination von Daten die durch unterschiedliche Prozesse gewonnen wurden. Der Einsatz von Big Data setzt also immer präventiv eine DSFA voraus, wenn davon personenbezogene Daten betroffen sind. Die Risikoanalyse der DSFA soll nach objektiven Kriterien (a) die mögliche Schwere eines Schadens (physisch, materiell, immateriell) und (b) die Eintrittswahrscheinlichkeit ermitteln, bewerten und abwägen (ErwG 76 DS-GVO). Die Betrachtung erfolgt dabei immer aus Sicht der betroffenen Personen, es geht um die Schwere des Eingriffs in die Grundrechte für die Betroffenen. Die DSFA verlangt eine systematische Beschreibung der Verarbeitungsvorgänge und der Zwecke der Verarbeitung. Dies beinhaltet eine detaillierte Bewertung der Prozesse, IT-Systeme, Datenflüsse und Systemgrenzen. Mindestens fordert die Verordnung (Art. 35 Abs. 7) eine systematische Beschreibung der geplanten Verarbeitungsvorgänge und der Zwecke der Verarbeitung, eine Bewertung der Notwendigkeit und Verhältnismäßigkeit der Verarbeitungsvorgänge in Bezug auf den bestimmten Zweck sowie eine Bewertung der daraus entstehenden Risiken für die Rechte und Freiheiten der betroffenen Personen. Abschließend sind Abhilfemaßnahmen zu bestimmen und der Nachweis dafür zu erbringen, dass die DS-GVO eingehalten wird. Der Zweck ist auch hier wieder zentraler Ansatzpunkt. Hinsichtlich des Verarbeitungsvorgangs einer Big Data-Analyse besteht somit die Anforderung, den Zweck eindeutig und legitim festzulegen. Die DSFA baut auf das Verzeichnis der Verarbeitungstätigkeiten (Art. 30 DS-GVO) auf, etwa auf die dortige Feststellung des Schutzbedarfs. Zu beschreiben sind berechtigte Interessen des Unternehmens an der Verarbeitung sowie die Erforderlichkeit dieser Verarbeitung, eine anschließende systematische Risikobeurteilung sowie die getroffenen Maßnahmen, um das Risiko für die betroffenen Personen zu minimieren. Besteht nach erfolgter Risikoanalyse ein hohes Risiko, ist die zuständige Aufsichtsbehörde zu konsultieren. VI. FazitDas neue Datenschutzrecht der EU – im Kern die DS-GVO – trägt dem Umstand Rechnung, dass mit dem Einsatz von Big Data (allgemeiner: analytischer Verfahren) besonders hohe Risiken für Grundrechte betroffener natürlicher Personen verbunden sind. Die Bewertung und Abwägung der Risiken werden zum Ansatzpunkt wenn es um die Frage geht, ob bzw. verbunden mit welchen Schutzmaßnahmen eine Verarbeitung zulässig ist. Dabei sind weiterhin die etablierten Grundsätze des Datenschutzes einzuhalten und zugleich neue (im Ansatz technikneutrale) Regeln für das Profiling – dem Rechtsbegriff zur Beschreibung von Big Data und ähnlicher Verfahren – genutzt. Gerade die wachsende Bedeutung analytischer Aufgaben und Big Data sowie die umfassende Pflicht zum Nachweis der Rechtskonformität lässt den Datenschutz in Unternehmen von einer Rand- zu einer zentralen Rechtsmaterie werden. Der risikoorientierte Ansatz ermöglicht Unternehmen nach Bewertung und Abwägung geeignete Maßnahmen zu treffen, um Big Data – unter Berücksichtigung von Rechtmäßigkeit und Grundprinzipien – rechtskonform anzuwenden. Konkret bleibt zum jetzigen Zeitpunkt allerdings offen, wie einzelne Regeln der DS-GVO ausgelegt werden müssen. Dies trifft etwa auf die Möglichkeit einer Zweckänderung zu oder auf die Frage, was eine erhebliche Beeinträchtigung automatischer Einzelentscheidungen ist bzw. nicht ist. Teilweise werden wohl erst Gerichte dies endgültig klären. Offen bleibt auch die Frage, ob es unter den Bedingungen von Big Data noch Anonymität gibt. Die Angemessenheit des zuweilen kritisierten technikneutralen Ansatzes wird sich u.a. auch an einer Antwort auf diese Frage entscheiden. Für Unternehmen, die den Einsatz von Big Data mit personenbezogenen Daten beabsichtigen, besteht jedenfalls die Notwendigkeit ein Datenschutz-Management-System zur Erfüllung umfassender Nachweispflichten über die Rechtskonformität (Compliance) einzuführen. VII. LiteraturArning, M.A.: Datenpools – Big Data datenschutzkonform umsetzen. In: K&R Beiheft 3, 2015, S. 7-12. Article 29 Data Protection Working Party (Ed.): Guidelines on Data Protection Impact Assessment (DPIA) and determining whether processing is "likely to result in a high risk" for the purposes of Regulation 2016/679. Brussels, 4. April 2017 (WP 249). Barocas, S./Selbst, A.D.: Big Data's Disparate Impact. In: California Law Review 3, 2016, S. 671-732. BfDI (Hrsg): Datenschutz-Grundverordnung. 2. Aufl. Bonn 2016 (BfDI - Info 6). Boehme-Neßler, V.: Das Ende der Anonymität – Wie Big Data das Datenschutzrecht verändert. In: DuD Datenschutz und Datensicherheit 7, 2016, S. 419-422. Buchner, B.: Grundsätze und Rechtmäßigkeit der Datenverarbeitung unter der DS-GVO. In: DuD Datenschutz und Datensicherheit 3, 2016, S. 155-161. Diercks, N.: Big Data im Zeitalter der EU-Datenschutzgrundverordnung (DSGVO) – Teil 6 zur EU-DSGVO. http://www.socialmediarecht.de/2016/11/29/big-data-im-zeitalter-der-eu-datenschutzgrundverordnung-dsgvo-teil-6-zur-eu-dsgvo/, (Abruf: 3.7.2017). Dix, A.: Datenschutz im Zeitalter von Big Data: Wie steht es um den Schutz der Privatsphäre? In: Stadtforschung und Statistik 1, 2016, S. 59-64. Dorschel, J. / Nauerth, P.: Big Data und Datenschutz â ein Überblick über die rechtlichen und technischen Herausforderungen. In: Wirtschaftsinformatik & Management 2, 2013, S. 32-38. EFI – Expertenkommission Forschung und Innovation: Gutachten zu Forschung, Innovation und technologischer Leistungsfähigkeit Deutschlands 2016. Berlin: EFI, 2016. Golla, S.J.: Is Data Protection Law Growing Teeth? The Current Lack of Sanctions in Data Protection Law and Administrative Fines under the GDPR. In: Journal of Intellectual Property, Information Technology and Electronic Commerce Law 1, 2017, S. 70-78. Kiesche, E.: So funktioniert die Folgenabschätzung. In: Computer und Arbeit 2, 2017, S. 31-36. Kipker, D.-K.: Privacy by Default und Privacy by Design. In: DuD Datenschutz und Datensicherheit 6, 2015, S. 410. Körner, M.: Die Datenschutzgrundverordnung der Europäischen Union: Struktur und Ordnungsprinzipien. Fakultät für Wirtschafts- und Sozialwissenschaften , Universität Hamburg, 2017 (Rechtswissenschaftliche Beiträge der Hamburger Sozialökonomie; Heft 12). Kring, M.: Big Data und der Grundsatz der Zweckbindung. In: Plödereder, E. et al. (Hrsg.): Informatik 2014. Gesellschaft für Informatik, Bonn 2014, S. 551-562. Lauser, R.: Data Warehouse vs. Datenschutz. In: Computerwoche vom 15.7.2014. https://www.computerwoche.de/a/data-warehouse-vs-datenschutz,2554608 (Abruf am 3.7.2017). Martini, M.: Big Data als Herausforderung für das Datenschutzrecht und den Persönlichkeitsschutz. In: Hill, H. et al. (Hrsg.): Die digitale Lebenswelt gestalten. Baden-Baden 2015, S. 97-162. Marnau, N.: Anonymisierung, Pseudonymisierung und Transparenz für Big Data. In: DuD Datenschutz und Datensicherheit 7, 2016, S. 428-433. Richards, N.M./King, J.H.: Big Data Ethics. In: Wake Forest Law Review, May 19, 2014, S. 394-432. Roßnagel, A./Nebel, M.: Die neue Datenschutzgrundverordnung - Ist das Datenschutzrecht nun für heutige Herausforderungen gerüstet? Karlsruhe: Forum Privatheit, 2016. Weichert, T.: Die Europäische Datenschutz-Grundverordnung – Ein Überblick. In: Datenschutz Nachrichten 39 (2016) 2, S. 48-56. Weichert, T.: Big Data – eine Herausforderung für den Datenschutz. In: Geiselberger, H./Moorstedt, T. (Red.): Big Data: Das neue Versprechen der Allwissenheit. Berlin: Suhrkamp, 2013. S. 131-148. Wybitul, T.: EU-Datenschutz-Grundverordnung in der Praxis – Was ändert sich durch das neue Datenschutzrecht? In: Betriebs-Berater 18, 20166, S. 1077-1081. Wybitul, T./Böhm, W.-T.: Das neue EU-Datenschutzrecht: Folgen für Compliance und interne Ermittlungen. In: Compliance-Berater 4, 2016, S. 101-108 (und Update v. 14.4.2016). | * Der Text ist die
erweiterte schriftliche Fassung eines Keynote-Vortrags auf dem Big-Data-
and Data-Science-Day am 25. Juli 2017 an der Hochschule der Medien in
Stuttgart. Prof. Holger Nohr lehrt und forscht im Studiengang
Wirtschaftsinformatik und digitale Medien an der Hochschule der Medien
Stuttgart, insbes. zu den Themen Datenschutz / Privacy und
Netzpolitik. | | * Der Text ist die erweiterte schriftliche Fassung eines Keynote-Vortrags auf dem Big-Data- and Data-Science-Day am 25. Juli 2017 an der Hochschule der Medien in Stuttgart. Prof. Holger Nohr lehrt und forscht im Studiengang Wirtschaftsinformatik und digitale Medien an der Hochschule der Medien Stuttgart, insbes. zu den Themen Datenschutz / Privacy und Netzpolitik. | [1] Vgl. Weichert
2013, S. 133ff. | | [1] Vgl. Weichert 2013, S. 133ff. | [2] Vgl. Weichert
2013, Richards/King 2014 und Barocas/Selbst 2016. | | [2] Vgl. Weichert 2013, Richards/King 2014 und Barocas/Selbst 2016. | [3] Vgl. BfDI 2016,
S. 7. | | [3] Vgl. BfDI 2016, S. 7. | [4] Vgl. EFI 2016,
S. 60ff. | | [4] Vgl. EFI 2016, S. 60ff. | [5] Vgl. Körner
2017, S. 10. | | [5] Vgl. Körner 2017, S. 10. | [6] Vgl. Körner
2017, S. 9 und 21. | | [6] Vgl. Körner 2017, S. 9 und 21. | [7] Dix 2016, S.
60. | | [7] Dix 2016, S. 60. | [8] Dix 2016, S. 61
und Boehme-Neßler 2016. | | [8] Dix 2016, S. 61 und Boehme-Neßler 2016. | [9] BfDI 2016, S.
9ff. | | [9] BfDI 2016, S. 9ff. | [10] Vgl.
Weichert 2016 und Wybitul 2016. | | [10] Vgl. Weichert 2016 und Wybitul 2016. | [11] Vgl. Buchner
2016, S. 157f. | | [11] Vgl. Buchner 2016, S. 157f. | [12] Vgl. Kipker
2015. | | [12] Vgl. Kipker 2015. | [13] Wybitul/Böhm 2016. | | [13] Wybitul/Böhm 2016. | [14] Vgl. Golla
2017. | | [14] Vgl. Golla 2017. | [15] Vgl.
Dorschel/Nauert 2013. | | [15] Vgl. Dorschel/Nauert 2013. | [16] Vgl. Lauser
2014. | | [16] Vgl. Lauser 2014. | [17] Vgl. Arning
2015, S. 10f. | | [17] Vgl. Arning 2015, S. 10f. | [18] Vgl. Arning
2015, S. 9. | | [18] Vgl. Arning 2015, S. 9. | [19] Vgl. Buchner
2016, S. 158f. | | [19] Vgl. Buchner 2016, S. 158f. | [20] Vgl. Kring
2014 und Martini 2015. | | [20] Vgl. Kring 2014 und Martini 2015. | [21] Die
Technikneutralität auch bzgl. Big Data wird teilw. kritisch
gesehen, u.a von Roßnagel/Nebel 2016, S. 6. | | [21] Die Technikneutralität auch bzgl. Big Data wird teilw. kritisch gesehen, u.a von Roßnagel/Nebel 2016, S. 6. | [22] Vgl. Diercks
2016. | | [22] Vgl. Diercks 2016. | [23] Vgl. Martini
2015. | | [23] Vgl. Martini 2015. | [24] Zu
diskriminierenden Wirkungen von Data Mining vgl. Barocas/Selbst
2016. | | [24] Zu diskriminierenden Wirkungen von Data Mining vgl. Barocas/Selbst 2016. | [25] Vgl. Marnau
2016, S. 429ff. und Boehme-Neßler 2016. | | [25] Vgl. Marnau 2016, S. 429ff. und Boehme-Neßler 2016. | [26] Vgl.
Boehme-Neßler 2016, S. 422f. | | [26] Vgl. Boehme-Neßler 2016, S. 422f. | [27] Vgl. Marnau
2016, S. 429. | | [27] Vgl. Marnau 2016, S. 429. | [28] Vgl. Kiesche
2017, S. 32. | | [28] Vgl. Kiesche 2017, S. 32. | [29] Vgl. Article
29 Data Protection Working Party 2017, S. 7ff. | | [29] Vgl. Article 29 Data Protection Working Party 2017, S. 7ff. | (online seit: 15.08.2017) | | (online seit: 15.08.2017) |